分布式事务的方案选型我自己查过好几轮,这篇把 TCC、Saga、可靠消息、2PC、Seata AT 各自的原理和最适合的场景讲得比较清楚,整理一份存档。
在微服务架构下,跨服务的数据一致性保证是个绕不开的难题。如果在一次业务操作中,写多个 DB,或既写本地 DB、又调外部 RPC 接口,就会面临一致性问题,怎么保证跨库、跨系统的操作要么都成功、要么都失败呢?
先说结论,最常用的分布式事务方案是:TCC、Saga、可靠消息。最推荐的开源框架是 Apache Seata,支持多种分布式事务模式,包括 TCC、Saga、AT 等。下面展开介绍。
BASE 理论
在一个数据库事务内,多个 SQL 写操作可以保证强一致。而到了分布式场景,只能做到最终一致。这就引出了 BASE 理论:基本可用、软状态、最终一致性,即允许系统存在中间不一致状态,只要最终达到一致即可。分布式事务方案大多在 BASE 理论指导下,放弃强一致,追求最终一致。
主流方案和最佳场景
下面每种方案都用一个独立的、最适合的业务场景来介绍。
1. TCC
最佳场景:下单时扣库存、扣余额
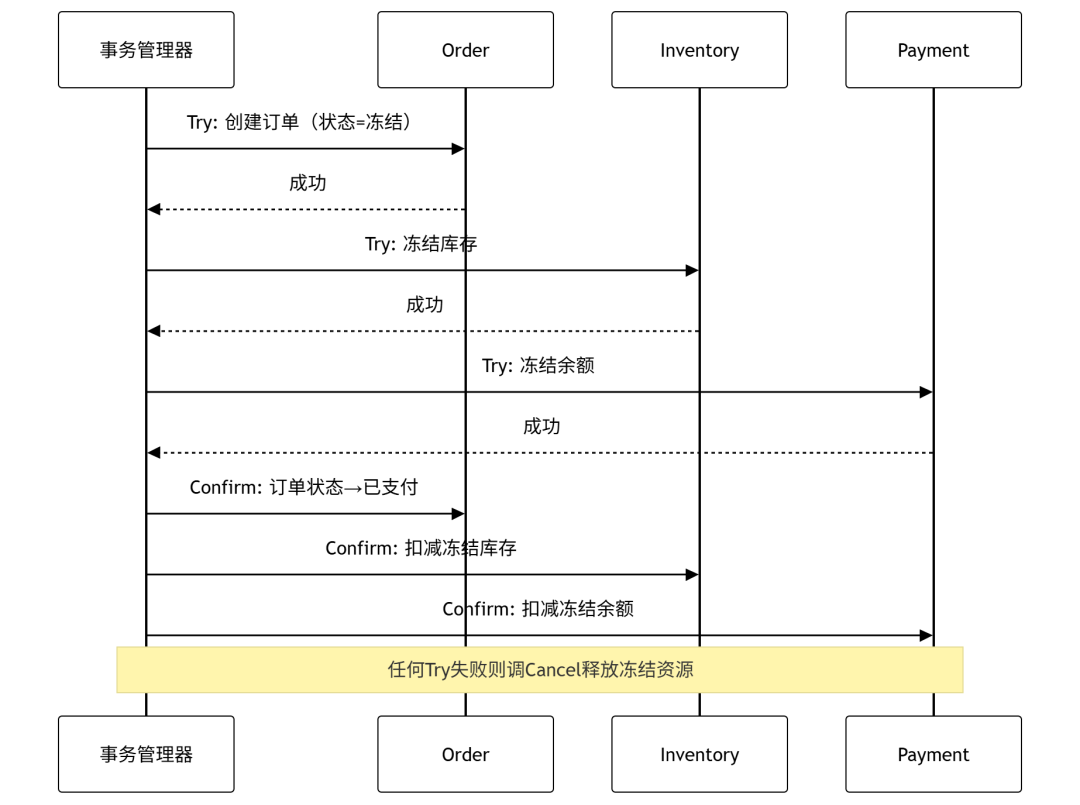
比如下单流程,涉及订单服务、库存服务、支付服务。需要同时创建订单、冻结库存、冻结余额,并发量较高,且对一致性要求严格。
原理与实现机制
TCC 需要一个协调者,一般称为事务管理器,负责编排整个流程。但资源锁定做到了业务层、而非 DB 层,由应用代码显式实现 Try、Confirm、Cancel 三个接口。
- TM(事务管理器):负责调用各个服务的 Try 方法,根据结果决定全部 Confirm 或全部 Cancel。需记录事务日志,处理重试和异常。
- RM(资源管理器):各业务服务自身,需要提供 Try/Confirm/Cancel 三个接口,并保证幂等(可能会调多次)。
流程细节
- TM 依次调用每个服务的 Try 接口,预留业务资源(如冻结库存、冻结余额),不用上数据库行锁。
- 若所有 Try 成功,TM 依次调用 Confirm 接口,将预留资源实际消耗或状态推进。
- 若任何 Try 失败或超时,TM 调用所有已成功服务的 Cancel 接口,释放预留资源。
- 框架需要处理空回滚(Try 未执行但 Cancel 被调用)、悬挂(Cancel 比 Try 先到)、幂等(接口被重复调用)等问题,一般通过记录全局事务状态,并用全局事务 ID 查询状态来实现。
举例:库存服务 Try/Confirm/Cancel
    // Try阶段:冻结库存、扣减可用库存
    @Transactional
    public boolean tryFreezeInventory(String productId, int qtyDelta, String txId) {
        // 冻结库存、扣减可用库存:update inventory set frozen_qty = frozen_qty + #{qtyDelta}, available_qty = available_qty - #{qtyDelta}
        // where product_id = #{productId} and available_qty - #{qtyDelta} > 0
        if (inventoryMapper.freeze(productId, qtyDelta) > 0) {
            // 冻结库存成功,记录库存变更明细,状态为TRY
            freezeRecordMapper.insert(txId, productId, qtyDelta);
            return true;
        } else {
            return false;
        }
    }

    // Confirm阶段:扣减冻结库存
    @Transactional
    public void confirm(String productId, int qtyDelta, String txId) {
        // 扣减冻结库存:update inventory set frozen_qty = frozen_qty - #{qtyDelta} where product_id = #{productId}
        inventoryMapper.deduct(productId, qtyDelta);
        // 更新库存变更明细为已完成
        freezeRecordMapper.updateStatus(txId, "CONFIRMED");
    }

    // Cancel阶段:释放冻结库存、可用库存
    @Transactional
    public void cancel(String productId, int qtyDelta, String txId) {
        FreezeRecord r = freezeRecordMapper.selectByTxId(txId);
        if (r == null) {
            return; // 空回滚
        }

        // 释放冻结库存、可用库存:update inventory set frozen_qty = frozen_qty - #{qtyDelta}, available_qty = available_qty + #{qtyDelta}
        // where product_id = #{productId}
        inventoryMapper.release(productId, qtyDelta);
        // 更新库存变更明细为已取消
        freezeRecordMapper.updateStatus(txId, "CANCELLED");
    }
TCC 将所有资源操作变成“预留”而非直接扣减,避免了数据库行锁长时间持有,非常适合秒杀、支付等并发高、资源竞争激烈的场景。
2. Saga
Saga 一词的本意是长篇故事,在分布式事务场景下是指一连串的事务。
最佳场景:出行预订(机票 + 酒店 + 门票)
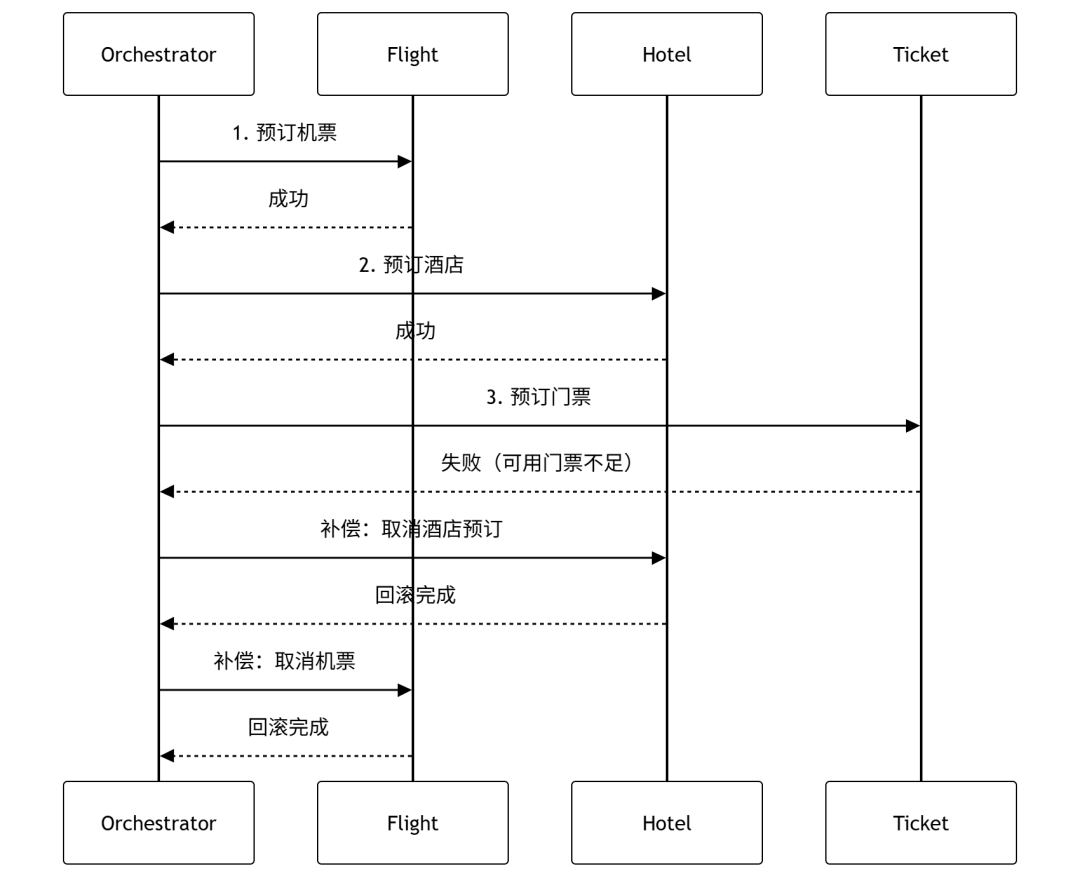
比如在线旅行平台,用户一次性预订机票、酒店、门票,三个服务相互独立、流程长,并且每个预订都会调用外部第三方接口。因为无法控制外部服务的实现,只能通过 Saga 模式,为每个调用外部接口的正向操作定义对应的补偿事务。
原理与实现机制
Saga 模式的核心思想是将一个长事务拆分为多个有序的本地事务,每个本地事务执行后直接提交,不锁定资源。如果后续步骤失败,则通过逆序调用之前的补偿事务来回滚。
Saga 常见的一种实现是编排式(Orchestration),此外还有无中心协调者的协同式(Choreography)。编排式下存在一个中心协调者(Orchestrator),它负责调用每个步骤的本地事务,并在失败时按逆序调用补偿。逻辑集中,易于监控。协调者需要持久化 Saga 状态机,以便在自身宕机后能够恢复并继续执行或补偿。
关键实现点
- 每个正向事务都必须有一个对应的补偿事务,且补偿必须是幂等的,因为可能存在重试。
- 缺少隔离性:Saga 不锁资源,中间状态可被读取到,因此业务设计上需要允许暂时的脏读(例如预订酒店后变为“酒店预订成功”,但因为机票出票失败后回滚为“酒店预订已取消”)。
- 补偿失败时需要告警并人工介入,因为回滚本身也可能失败。
举例:出行预订的正向事务与补偿
    // 正向事务:调用第三方接口预订酒店
    public Booking bookHotel(HotelReq req) {
        String bookingId = hotelApi.reserve(req);
        return bookingRepo.save(new Booking(bookingId, "RESERVED"));
    }

    // 补偿事务:取消预订
    public void cancelHotel(Booking booking) {
        hotelApi.cancel(booking.getBookingId());
        bookingRepo.updateStatus(booking.getId(), "CANCELLED");
    }
Saga 不占用数据库锁,各服务完全独立,非常适合调用外部服务、流程长的业务。代价是需要实现补偿逻辑,且中间状态可见,业务必须能容忍短暂的不一致。
3. 可靠消息
最佳场景:非核心链路的联动处理场景
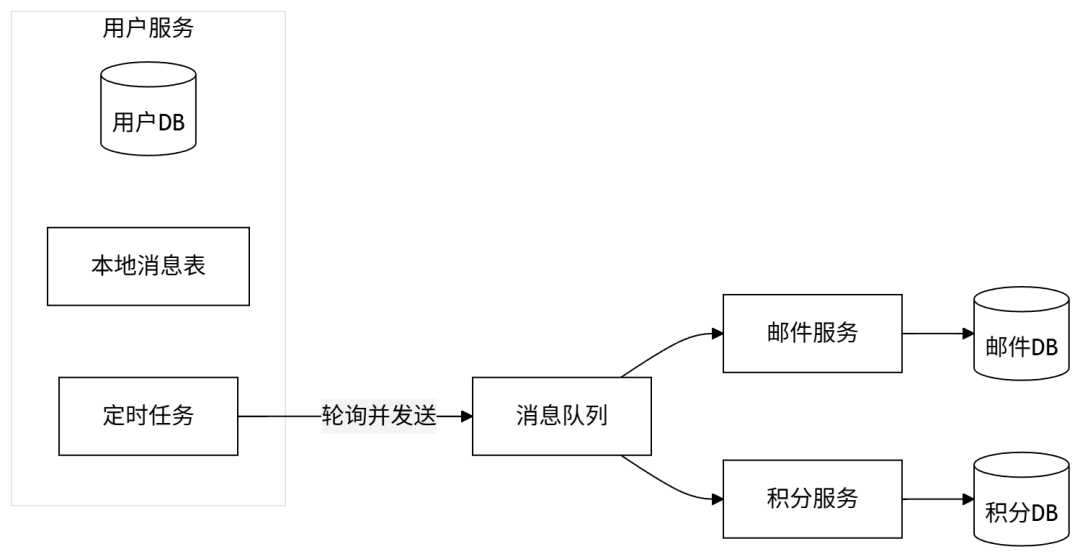
确保一定通知到、但可能多发消息,联动方需做好幂等。比如用户注册送积分场景,在用户注册后,需要发送欢迎邮件、初始化积分账户。这些动作可以异步完成,允许秒级延迟,但必须保证最终完成。
原理与实现机制
要实现可靠消息,需要通过本地消息表模式,即本地事务 + 消息队列实现最终一致。核心思想是将业务操作和消息持久化放在同一个 DB 事务中,然后通过后台任务将消息发送到 MQ,下游消费时保证幂等。
关键流程
- 消息生产方:执行业务操作的同时,向本地 DB 的 outbox 表插入一条“待发送”消息,两者在同一数据库事务中提交。然后发消息到 MQ,最后更新状态为“已发送”,这两步都可能失败。
- 兜底定时任务:定时查询 outbox 表中超过一定时间仍处于“待发送”状态的记录,将消息发送到 MQ,成功后更新状态为“已发送”。
- 消息消费方:监听消息,执行本地事务(如初始化积分),通过业务唯一键保证幂等。
举例:注册用户时写入本地消息表、发消息
-- 用户服务本地事务
BEGIN;
    INSERT INTO users(user_id, email, ...) VALUES(...);
    INSERT INTO outbox(message_id, topic, payload, status) VALUES('msg_reg_123', 'USER_REGISTERED', '{"userId":...}', 'PENDING');
COMMIT;
4. 两阶段提交(2PC,2 Phase Commit)
最佳场景:内部低并发强一致转账
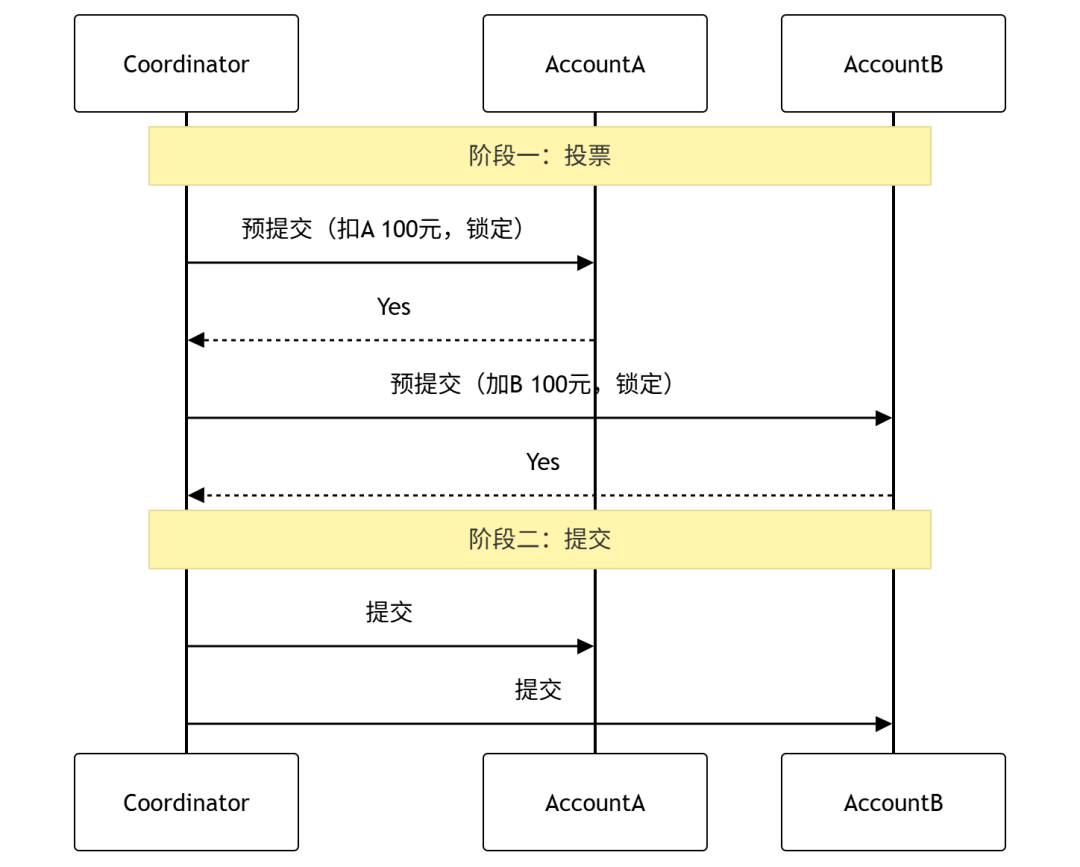
比如公司内部财务系统,A 账户向 B 账户转账,两个账户分别在不同数据库。并发量极低,但绝不允许出现金额不一致。
原理与实现机制
2PC 需要一个全局事务协调者(Coordinator),通常由事务管理器(如 JTA 实现)充当。参与者是各个资源管理器(RM),如数据库。
- 协调者:负责调度整个事务流程,发送指令,收集投票结果。
- 参与者:实际持有资源的节点,执行预提交和最终提交/回滚。
流程细节
- 阶段一(准备/投票):协调者向所有参与者发送事务内容,询问是否可以提交。参与者各自锁定资源(如数据库行锁),执行事务操作并写入 undo/redo 日志,但不提交,然后返回 Yes 或 No。
- 阶段二(提交/回滚):若所有参与者返回 Yes,协调者发送提交指令;若任一返回 No 或超时,则发送回滚指令,参与者根据指令完成提交或回滚并释放锁。但 2PC 存在“协调者单点故障”问题:若阶段二指令未能送达所有参与者,部分参与者可能处于不确定状态,需要人工介入或日志恢复。
举例:公司内部跨系统转账
通常基于 XA 协议实现,如 Java JTA。开发无需实现 Try/Confirm,但两个数据库资源在阶段一就被锁定,其他事务无法操作 A 和 B 的余额,直到协调者发出最终指令。内部管理系统的转账逻辑简单,并发低,这种强一致和阻塞是可以接受的。
5. AT 模式(Seata)
AT 模式是 Seata 引入的一种非侵入式的分布式事务解决方案,Seata 在内部对 DB 操作做了一层代理,会生成业务层的 undo log,相当于在业务层实现了 2PC。
最佳场景:无侵入改造老系统
比如一个老旧的单体应用刚拆分为订单服务和库存服务,数据库也一分为二。业务代码不想大改,又需要保证“下单必须扣库存”的事务一致性。
原理与实现机制
- 一阶段:在同一个本地事务中提交业务数据和 undo log,需先加全局锁。undo log 是业务回滚日志,在更新前查出前镜像,然后做更新操作,最后根据前镜像的主键 ID 查出后镜像,前镜像、后镜像的内容就是 undo log 的组成部分。
- 二阶段:提交成功后,异步删除对应的 undo log。回滚通过一阶段的 undo log 进行反向补偿。
举例:库存更新 SQL 是
update inventory set qty = qty - 1 WHERE product_id = 1001,Seata 自动记录前镜像qty=100、后镜像qty=99。回滚时生成 SQLupdate inventory set qty = 100 WHERE product_id = 1001。业务代码完全不用加 Try/Confirm/Cancel,只需引入 Seata 的代理数据源即可。
AT 模式适合对业务侵入性要求极低、SQL 操作相对简单的改造场景。但它依赖关系型数据库,默认读未提交,需注意脏读问题,复杂查询多或性能要求极高的场景要谨慎。
方案选项总结
| 方案 | 最适合的场景 | 一致性 | 性能 | 代码侵入性 |
|---|---|---|---|---|
| TCC | 资源争夺型高并发(下单扣库存、余额) | 强一致/最终一致 | 高 | 高 |
| Saga | 长流程、调用外部服务(旅行出游预订) | 最终一致 | 高 | 中 |
| 可靠消息 | 异步解耦的非核心流程(注册送积分) | 最终一致 | 高 | 中 |
| 2PC | 内部低并发强一致转账 | 强一致 | 低 | 低 |
| AT 模式 | 无侵入改造老系统 | 弱一致/读未提交 | 中 | 低 |
没有一套方案能覆盖所有分布式事务场景,做方案选型时重点关注:数据不一致的窗口能容忍多久?并发量有多大?是否能实现补偿逻辑?
再结合上述表格,就能找到最合适的分布式事务方案,通过 Apache Seata 来实现 TCC、Saga、AT 模式,通过本地消息表来实现可靠消息。
原文作者:Java 烘焙师
原文地址:分布式事务:TCC、Saga、可靠消息、2PC、Seata AT 模式